EN
Тихая проблема удалённых энергетических проектов
Системы автономного накопления энергии часто строятся там, где централизованная сеть недоступна: на островах, горнодобывающих объектах, телекоммуникационных вышках в пустыне, удалённых фермах. Эти места объединяет одна операционная реальность: отправка техника обходится дорого и занимает много времени. Во многих проектах техническое обслуживание проводится раз в несколько месяцев, а иногда — ещё реже.
Риск заключается не в том, что оборудование выходит из строя с громким шумом. Риск в том, что оно выходит из строя тихо. Скорость вращения вентилятора охлаждения снижается. Группа аккумуляторов постепенно теряет баланс. Модуль преобразования мощности работает с пониженной выходной мощностью в течение недель. К тому моменту, когда кто-то прибывает на место, проблема уже привела к полной остановке — или, что ещё хуже, к инциденту, угрожающему безопасности.
Вот почему удалённый мониторинг — это не «желательная дополнительная функция» для автономных проектов. Это единственный способ ответить на базовый операционный вопрос: выполняет ли оборудование свою задачу прямо сейчас?
Как выглядит «выполнение задачи» в цифровых данных
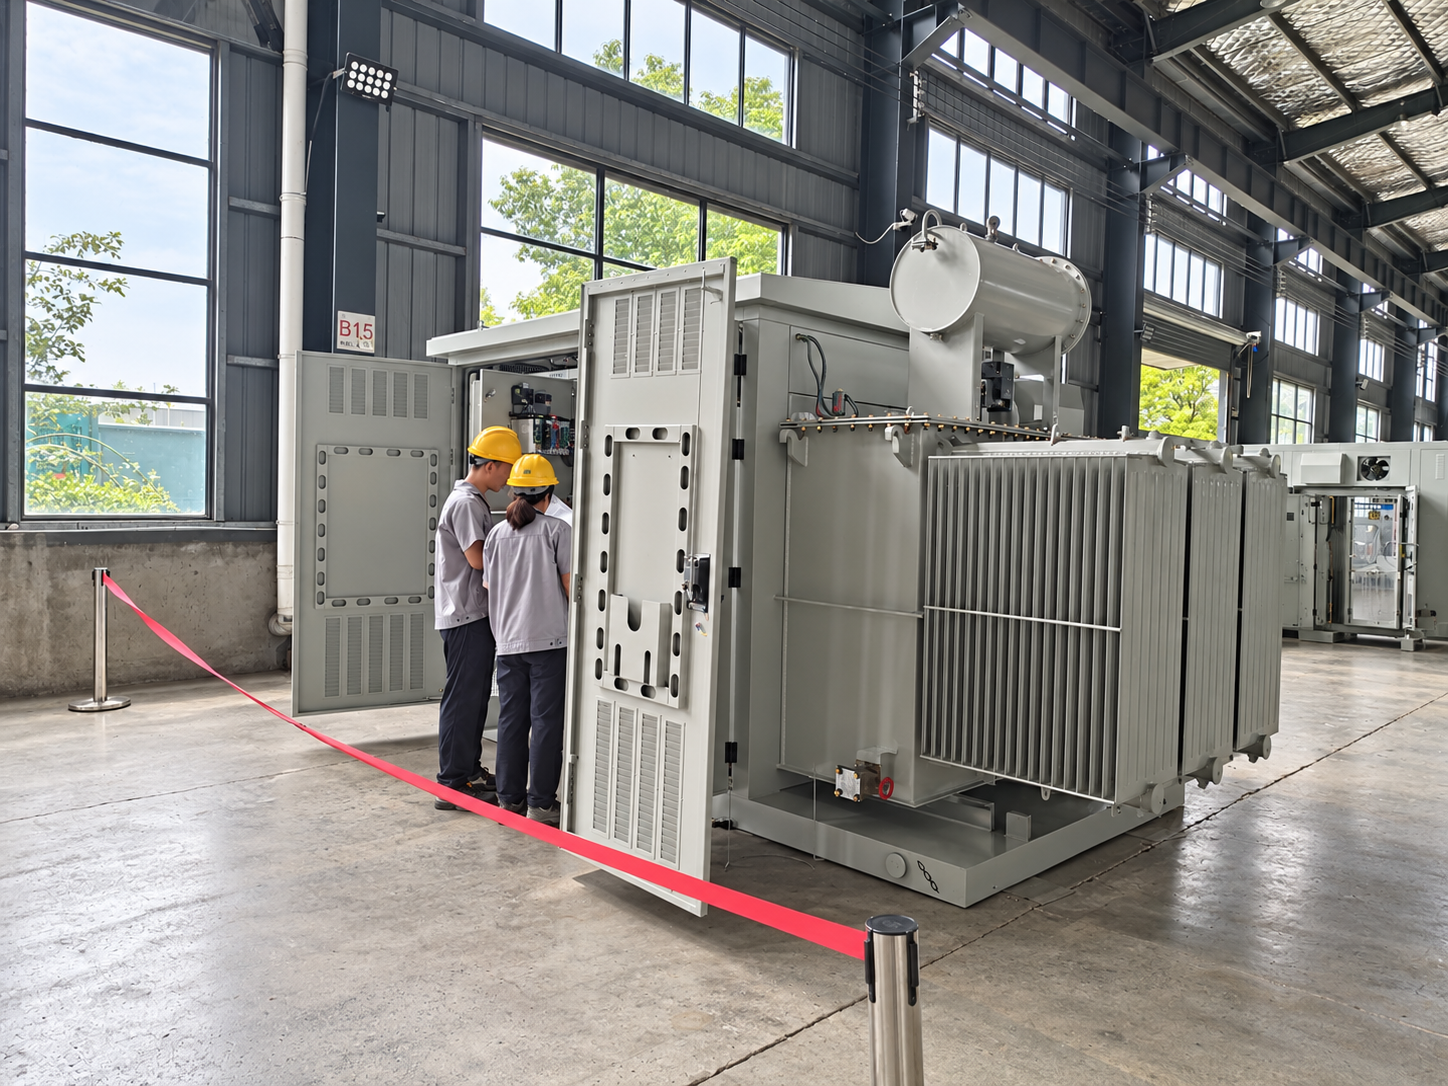
Для автономной системы, построенной вокруг кабины с интегрированной системой преобразования энергии (PCS), состояние «работает» — это не простой двоичный сигнал «да» или «нет». Это набор измерений, совместно описывающих, течёт ли электрическая энергия, безопасно ли управляется аккумулятор и приближается ли какая-либо часть системы к отказу.
Ключевые сигналы, имеющие значение
Система удалённого мониторинга для кабины с интегрированной PCS обычно собирает данные трёх уровней:
Режим работы: Включена ли PCS, выключена, находится в режиме зарядки, разрядки или аварийного состояния? Работает ли она под локальным управлением или принимает удалённые команды? Эти флаги состояния сразу показывают, доступна ли установка вообще.
Электрические измерения: Напряжение и ток переменного тока на каждой фазе, напряжение и ток постоянного тока на стороне аккумулятора, активная и реактивная мощность, частота и КПД преобразования. Эти значения показывают не только то, что проверить энергия перемещается, но и то, как насколько хорошо она перемещается. PCS, находящаяся в состоянии «включено», но выдающая лишь 70 % расчётной выходной мощности, считается неработоспособной, даже если никакая аварийная сигнализация не сработала.
Тепловые и экологические показания: Температура PCS, температура в салоне и состояние системы охлаждения. Перегрев зачастую является первым заметным признаком развивающейся неисправности в силовой электронике.
Сигналы тревоги и журнал событий
Помимо текущих измерений система регистрирует сигналы тревоги при таких условиях, как перенапряжение, пониженное напряжение, перегрузка по току, перегрев, потеря связи и нарушение изоляции. Хорошо спроектированная система мониторинга не ограничивается сообщением «всё в порядке», когда активных тревог нет. Она отображает
Самая сложная часть: надёжный вывод данных
В удалённых автономных местах канал связи зачастую является самым слабым звеном в цепочке мониторинга. Система может оснащаться превосходными датчиками, но всё равно терять удалённую видимость, если данные не могут надёжно передаваться с объекта в облако.
Почему надёжность передачи данных важнее объёма данных
Полевые исследования систем мониторинга вне сети показывают, что надёжность связи — это измеримый и поддающийся улучшению показатель. В одном оптимизированном проекте автономной фотоэлектрической системы с накоплением энергии коэффициент доставки данных — доля запланированных передач данных, фактически поступающих на сервер — возросла с 84,9 % до 99,2 % после модернизации системы. Эта разница в 14 процентных пунктов означает переход от «мы обычно знаем, что происходит» к «мы можем доверять данным мониторинга при принятии решений».
Хранение данных на периферии: что происходит при потере сети
Надёжная архитектура удалённого мониторинга не предполагает постоянную доступность сети. Локальные периферийные устройства буферизуют данные при потере соединения и передают их с задержкой после восстановления связи. Это особенно важно для журналов неисправностей и трендовых данных: если неисправность возникает во время отключения сети, запись об этом должна сохраниться и быть передана после восстановления канала.
Структура «Облако—Периферия—Устройство»
Практичный способ организации такой системы — трёхуровневая структура: датчики и контроллеры на уровне устройств, шлюз «edge», который собирает, хранит и предварительно обрабатывает данные локально, а также облачная платформа для удалённого доступа, анализа и генерации оповещений. Уровень «edge» обеспечивает наблюдаемость системы даже при прерывистом подключении к облаку, тогда как облачный уровень предоставляет инженерам и владельцам единый обзор нескольких удалённых объектов.
Как оценить «нормальность» дистанционно
Как только данные поступают надёжно, следующий вопрос — интерпретация. Оператору, работающему удалённо, невозможно выйти наружу и прослушать работу вентиляторов охлаждения. Оценка должна основываться на правилах, сравнениях и трендах.
Правила пороговых значений: первая линия защиты
Самый простой и прозрачный метод — это аварийное оповещение на основе пороговых значений. Если температура PCS превышает заданный предел, если напряжение постоянного тока падает ниже безопасного рабочего диапазона аккумулятора или если выходная мощность снижается до нуля при команде на разряд системы, генерируется оповещение. Эти правила легко объяснимы и легко поддаются аудиту, а также позволяют выявить большинство явных отказов.
Сравнение трендов: выявление дрейфа до наступления отказа
Одних только пороговых значений недостаточно, поскольку многие отказы развиваются постепенно. Более эффективный подход заключается в сравнении текущих показателей работы с историей работы самой системы и с аналогичными модулями. Например, если один модуль PCS в многомодульной кабине постоянно работает на 5 градусов теплее остальных при схожей нагрузке, это сигнал, требующий расследования — даже если ни один порог не был превышен. Если суточный объём переданной энергии медленно снижается в течение нескольких недель при стабильном уровне освещённости и нагрузки, система мониторинга должна выделить эту тенденцию, а не скрыть её в графике.
Прогнозирующие оповещения: превращение данных в запас времени
Современные платформы мониторинга применяют алгоритмы к историческим и потоковым данным, чтобы выявлять условия, предшествующие отказу. Для кабин, интегрированных с PCS, это может означать распознавание закономерностей в росте температуры, отклонении напряжения или частоте ошибок связи, которые в прошлом коррелировали с деградацией компонентов. Практическая ценность — запас времени: вместо вызова техника после аварийного отключения оператор может запланировать ремонт во время следующего заранее запланированного технического обслуживания, уже имея на руках нужные запасные части и точную диагностику.
Что это означает на практике для кабины с интегрированной PCS
Для проекта с использованием интегрированной кабины PCS в автономном (off-grid) месте функция удалённого мониторинга должна давать краткие ответы на ключевые эксплуатационные вопросы без необходимости выезда на объект:
• Работает ли PCS в ожидаемом режиме и обеспечивает ли требуемую мощность?
• Находится ли аккумулятор в пределах безопасных значений напряжения, тока и температуры?
• Работает ли канал связи исправно, и если нет, сохраняются ли локальные данные?
• Повторяются ли тревожные сигналы или наблюдаются ли медленные тенденции, указывающие на деградацию компонента?
• Что произошло во время последнего отказа сети и полна ли эта запись?
Система, способная надёжно отвечать на эти вопросы, меняет экономическую модель удалённой эксплуатации. Вместо «приехать и выяснить» техническое обслуживание превращается в «наблюдать, принимать решение и приезжать с чёткой целью». Для автономных проектов, где каждый выезд на объект связан с реальными затратами, такое изменение — не техническая деталь. Это разница между реактивным ремонтом и управляемой эксплуатацией.
Сценарии применения
В таблице ниже кратко описаны пять типичных сценариев применения удалённого мониторинга кабин с интегрированной системой PCS для автономных объектов.
Сценарий применения |
Типичное расположение |
Ключевые аспекты мониторинга |
Основная польза |
Ключевой показатель |
Фотоэлектрические электростанции |
Солнечные фермы в пустынях или на островах |
Эффективность инвертора, температура панелей, постоянное напряжение |
Максимизировать выработку энергии; сократить незапланированные простои |
Соотношение суточной выработки энергии |
Ветровые фермы |
Удалённые участки на склонах холмов или побережье |
Выход генератора, температура редуктора, частота сети |
Прогнозирующее техническое обслуживание; увеличение срока службы турбины |
Коэффициент использования мощности |
Системы хранения энергии |
Автономные микросети / островные сети |
Уровень заряда (SOC) и состояние здоровья (SOH) аккумулятора, тепловое состояние PCS, количество циклов зарядки |
Обеспечить безопасность аккумулятора; оптимизировать циклы зарядки |
Эффективность цикла зарядки/разрядки |
Телекоммуникационные базовые станции |
Опоры в горах или пустыне |
Стабильность электропитания, резервный аккумулятор, уровень топлива |
Обеспечить время безотказной работы на уровне 99,9 %; минимизировать выезды на объект |
Коэффициент готовности |
Горные операции |
Удалённые горнодобывающие объекты / карьеры |
Управление высокими нагрузками, координация между генератором и PCS |
Обеспечить непрерывность эксплуатации; сократить потери топлива |
Коэффициент загрузки |
Часто задаваемые вопросы
Вопрос 1: Что происходит с данными мониторинга при потере сетевого соединения?
Локальные edge-устройства автоматически буферизуют все измерительные данные, журналы аварийных сигналов и записи событий во время перерывов в сетевой связи. После восстановления связи накопленные данные передаются в облачную платформу, обеспечивая полную и непрерывную историю без пропусков. Возможность локального хранения данных на edge-устройствах имеет решающее значение для автономных объектов, где нестабильное подключение — это норма, а не исключение.
Вопрос 2: Как система может обнаруживать неисправности до того, как они вызовут остановку?
Платформа мониторинга использует три взаимодополняющих метода: срабатывание тревоги по пороговым значениям при немедленных критических отказах, сравнение тенденций для выявления постепенного дрейфа параметров, таких как температура и напряжение, а также прогнозные алгоритмы, распознающие закономерности, исторически связанные с деградацией компонентов. В совокупности эти подходы обеспечивают опережающее время для планирования технического обслуживания вместо реагирования на аварийные ситуации.
Вопрос 3: Устраняет ли удалённый мониторинг необходимость в выездах на объект для технического обслуживания?
Нет — удалённый мониторинг не заменяет физическое техническое обслуживание, но принципиально меняет способ планирования и выполнения выездов. Вместо периодических инспекций по принципу «приехал — увидел — определил», операторы могут запланировать целевые выезды с уже поставленным диагнозом и необходимыми запасными частями. Такой переход от реактивной к управляемой эксплуатации значительно снижает как частоту, так и стоимость выездов на объект, одновременно повышая надёжность оборудования.
Вопрос 4: В чём разница между правилами пороговых значений, сравнением трендов и прогнозирующими оповещениями?
Правила пороговых значений инициируют оповещение, когда измеренное значение превышает заранее заданный предел — они выявляют внезапные, очевидные отказы. Сравнение трендов анализирует, как параметр изменяется во времени относительно собственной истории и аналогичных устройств, выявляя постепенную деградацию, которая никогда не превышает пороговое значение. Прогнозирующие оповещения применяют алгоритмы к историческим и потоковым данным для выявления условий, предшествующих отказу, обеспечивая полезный интервал времени для планирования технического обслуживания.
Вопрос 5: Почему архитектура «Облако—Граничное устройство—Устройство» рекомендуется для мониторинга вне электросети?
Эта трёхуровневая архитектура решает основную проблему ненадёжной связи в удалённых местах. Уровень устройств отвечает за сбор данных и управление. Уровень «edge» («на краю сети») собирает, хранит и предварительно обрабатывает данные локально, обеспечивая наблюдаемость системы даже при потере соединения с облаком. Облачный уровень обеспечивает централизованный доступ, межплощадочное анализирование и долгосрочный тренд-анализ. Каждый уровень имеет чёткую функциональную роль, а система остаётся работоспособной даже при временной недоступности одного из уровней.
123