EN
El problema silencioso de los proyectos remotos de energía
Los sistemas de almacenamiento de energía fuera de la red suelen construirse donde la red eléctrica no llega: islas, sitios mineros, torres de telecomunicaciones en el desierto, granjas remotas. Estos lugares comparten una realidad operativa común: enviar un técnico es costoso y lento. En muchos proyectos, una visita de mantenimiento ocurre cada varios meses, y a veces con menor frecuencia.
El riesgo no radica en que el equipo falle de forma ruidosa. El riesgo radica en que falle de forma silenciosa. Un ventilador de refrigeración reduce su velocidad. Una batería se desequilibra progresivamente. Un módulo de conversión de potencia opera a una salida reducida durante semanas. Para cuando alguien llega, el problema ya ha derivado en una parada total —o peor aún, en un incidente de seguridad.
Por esta razón, la supervisión remota no es una característica «deseable» para proyectos fuera de la red. Es la única forma de responder a una pregunta operativa básica: ¿Está el equipo realizando efectivamente su función en este momento?
Cómo se ve «realizar su función» en los datos
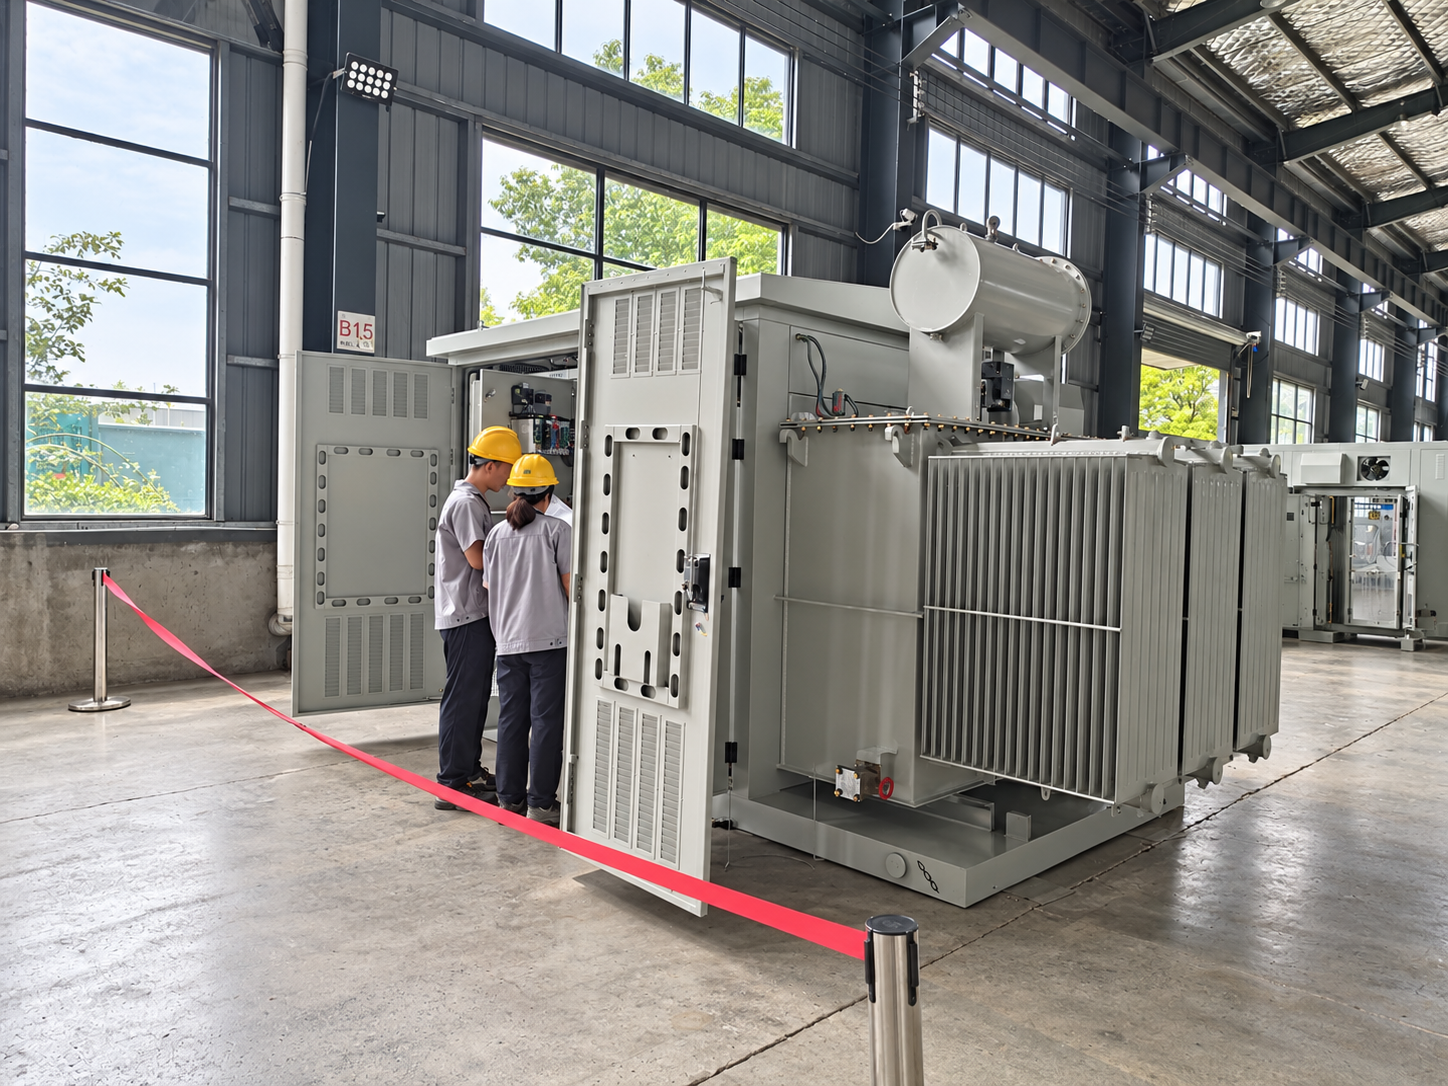
Para un sistema aislado construido alrededor de una cabina integrada con un PCS (sistema de conversión de potencia), «funcionar» no es una señal binaria de sí o no. Es un conjunto de mediciones que, en conjunto, indican si la potencia está fluyendo, si la batería se gestiona de forma segura y si algún parámetro se desvía hacia un fallo.
Las señales fundamentales que importan
Un sistema remoto de supervisión para una cabina integrada con PCS normalmente recopila tres niveles de datos:
Estado de funcionamiento: ¿Está el PCS encendido, apagado, cargando, descargando o en estado de fallo? ¿Funciona bajo control local o acepta órdenes remotas? Estas banderas de estado indican de inmediato si la unidad está disponible o no.
Mediciones eléctricas: Tensión y corriente CA en cada fase, tensión y corriente CC en el lado de la batería, potencia activa y reactiva, frecuencia y eficiencia de conversión. Estos valores no solo muestran si si la potencia está circulando, sino también qué tan bien cómo lo está haciendo. Un PCS que está «encendido» pero que entrega el 70 % de la potencia esperada no está sano, incluso si aún no se ha activado ninguna alarma.
Lecturas térmicas y ambientales: Temperatura del PCS, temperatura de la cabina y estado del sistema de refrigeración. El calor suele ser el primer signo visible de un problema emergente en la electrónica de potencia.
Alarmas y registros de eventos
Más allá de las mediciones en tiempo real, el sistema registra alarmas para condiciones como sobretensión, subtensión, sobreintensidad, sobrecalentamiento, pérdida de comunicación y fallos de aislamiento. Una plataforma de monitorización bien diseñada no se limita a indicar «todo está bien» cuando no hay alarmas activas. Muestra el
Lo difícil: transmitir los datos de forma fiable
En ubicaciones remotas fuera de la red eléctrica, el enlace de comunicación suele ser la parte más débil de la cadena de monitorización. Un sistema puede tener sensores excelentes y aun así fallar en la visibilidad remota si los datos no pueden viajar desde el sitio hasta la nube de forma fiable.
Por qué la conectividad de los datos importa más que el volumen de datos
Los estudios de campo sobre sistemas de monitorización fuera de la red muestran que la fiabilidad de la comunicación es una métrica cuantificable y mejorable. En un proyecto optimizado de fotovoltaica y almacenamiento fuera de la red, la tasa de conectividad de datos —es decir, el porcentaje de transmisiones programadas que efectivamente llegan al servidor— aumentó del 84,9 % al 99,2 % tras las mejoras del sistema. Esa diferencia de 14 puntos porcentuales marca la diferencia entre «normalmente sabemos lo que está ocurriendo» y «podemos confiar en los datos de monitorización para tomar decisiones».
Almacenamiento periférico: ¿qué ocurre cuando se interrumpe la red?
Una arquitectura robusta de monitorización remota no parte de la premisa de que la red esté siempre disponible. Los dispositivos locales periféricos almacenan temporalmente los datos cuando se pierde la conexión y los envían posteriormente una vez restablecida la comunicación. Esto resulta especialmente importante para los registros de fallos y los datos de tendencias: si ocurre un fallo durante una interrupción de la red, el registro debe seguir existiendo cuando se recupere la conexión.
Estructura «Nube-Periferia-Dispositivo»
Una forma práctica de organizar esto es una estructura de tres capas: sensores y controladores en el nivel del dispositivo, una pasarela de borde que recopila, almacena y preprocesa los datos localmente, y una plataforma en la nube para acceso remoto, análisis y alertas. La capa de borde mantiene el sistema observable incluso cuando la conexión a la nube es intermitente, mientras que la capa en la nube brinda a los ingenieros y propietarios una vista unificada de múltiples sitios remotos.
Cómo juzgar lo "normal" desde lejos
Una vez que los datos fluyen de forma fiable, la siguiente pregunta es su interpretación. Un operador remoto no puede salir afuera y escuchar los ventiladores de refrigeración. El juicio debe basarse en reglas, comparaciones y tendencias.
Reglas de umbral: la primera línea de defensa
El método más sencillo y transparente es la alerta basada en umbrales. Si la temperatura del PCS supera un límite configurado, si el voltaje de corriente continua cae por debajo del rango seguro de operación de la batería o si la potencia de salida desciende a cero mientras el sistema recibe la orden de descargar, se genera una alerta. Estas reglas son fáciles de explicar y fáciles de auditar, y detectan la mayoría de los fallos graves.
Comparación de tendencias: detectar la deriva antes del fallo
Los umbrales solos no bastan, porque muchos fallos se desarrollan progresivamente. Un enfoque más eficaz compara el rendimiento actual con el historial propio del sistema y con el de unidades similares. Si un módulo PCS en una cabina de múltiples módulos opera de forma constante 5 grados más caliente que los demás bajo cargas similares, eso constituye una señal digna de investigación, incluso si ningún umbral ha sido superado. Si el rendimiento energético diario disminuye lentamente durante semanas mientras la irradiación y la carga permanecen estables, el sistema de monitorización debe resaltar esa tendencia, no enterrarla en una gráfica.
Alertas predictivas: Convertir los datos en tiempo de anticipación
Actualmente, las plataformas avanzadas de supervisión aplican algoritmos a datos históricos y en tiempo real para detectar condiciones que preceden a una falla. En el caso de cabinas integradas con PCS, esto puede significar identificar patrones en el aumento de temperatura, la desviación de voltaje o la frecuencia de errores de comunicación que, históricamente, se correlacionan con la degradación de componentes. El valor práctico radica en el tiempo de anticipación: en lugar de enviar a un técnico tras una parada, el operador puede programar una visita de reparación durante la siguiente ventana planificada de mantenimiento, contando ya con las piezas de repuesto adecuadas y el diagnóstico correcto.
Qué significa esto en la práctica para una cabina integrada con PCS
En un proyecto que utilice una cabina integrada con PCS en una ubicación aislada, la capacidad de supervisión remota debe responder a una breve lista de preguntas operativas sin requerir una visita al sitio:
• ¿El PCS está funcionando en el modo esperado y está suministrando la potencia prevista?
• ¿La batería opera dentro de los límites seguros de voltaje, corriente y temperatura?
• ¿El enlace de comunicación está funcionando correctamente y, si no es así, ¿se están conservando los datos locales?
• ¿Hay alarmas recurrentes o tendencias lentas que sugieran un deterioro de algún componente?
• ¿Qué ocurrió durante la última interrupción de la red y está completo ese registro?
Un sistema capaz de responder a estas preguntas de forma fiable transforma la economía de la operación remota. En lugar de «visitar y descubrir», el mantenimiento pasa a ser «monitorear, decidir y visitar con un propósito definido». En proyectos aislados de la red, donde cada visita al sitio implica un costo real, este cambio no es un detalle técnico: es la diferencia entre una reparación reactiva y una operación gestionada.
Escenarios de aplicación
La tabla siguiente resume cinco escenarios típicos de aplicación aislada de la red para sistemas de monitoreo remoto integrados en cabinas con PCS.
Escenario de Aplicación |
Ubicación Típica |
Enfoque clave de monitoreo |
Beneficio principal |
Indicador clave |
Plantas solares fotovoltaicas |
Granjas solares en desiertos o islas |
Eficiencia del inversor, temperatura de los paneles, voltaje de corriente continua |
Maximizar la captación de energía; reducir las paradas no planificadas |
Relación diaria de producción energética |
Granjas Eólicas |
Emplazamientos remotos en laderas montañosas o zonas costeras |
Producción del generador, temperatura de la caja de cambios, frecuencia de la red |
Mantenimiento predictivo; prolongar la vida útil de las turbinas |
Factor de capacidad |
Sistemas de almacenamiento de energía |
Microredes aisladas o redes insulares |
Nivel de carga (SOC) y estado de salud (SOH) de la batería, estado térmico del convertidor de potencia (PCS), ciclos de carga |
Garantizar la seguridad de la batería; optimizar los ciclos de carga y descarga |
Eficiencia de Ciclo Completo |
Estaciones base de telecomunicaciones |
Torres ubicadas en montañas o desiertos |
Estabilidad del suministro eléctrico, batería de respaldo, nivel de combustible |
Mantener una disponibilidad del 99,9 %; minimizar las visitas al sitio |
Tasa de disponibilidad |
Operaciones Mineras |
Sitios mineros remotos / canteras |
Gestión de cargas pesadas, coordinación entre generador y sistema de conversión de potencia (PCS) |
Garantizar la continuidad operativa; reducir el desperdicio de combustible |
Factor de carga |
Preguntas frecuentes
P1: ¿Qué ocurre con los datos de supervisión cuando se pierde la conexión de red?
Los dispositivos periféricos locales almacenan automáticamente en búfer todos los datos de medición, los registros de alarmas y los registros de eventos durante las interrupciones de la red. Una vez restablecida la comunicación, los datos almacenados en búfer se envían al sistema en la nube, garantizando un registro histórico completo sin interrupciones. Esta capacidad de almacenamiento periférico es fundamental en sitios aislados, donde la conectividad intermitente es la norma y no la excepción.
P2: ¿Cómo puede el sistema detectar fallos antes de que provoquen una parada?
La plataforma de supervisión utiliza tres métodos complementarios: alertas basadas en umbrales para detectar fallos graves inmediatos, comparación de tendencias para identificar desviaciones graduales en parámetros como la temperatura y el voltaje, y algoritmos predictivos que reconocen patrones históricamente asociados con la degradación de componentes. En conjunto, estos enfoques brindan tiempo anticipado para realizar mantenimiento planificado, en lugar de reparaciones de emergencia reactivas.
P3: ¿La supervisión remota elimina la necesidad de visitas de mantenimiento in situ?
No: la supervisión remota no sustituye el mantenimiento físico, pero transforma radicalmente la forma en que se planifican y ejecutan las visitas. En lugar de inspecciones periódicas del tipo «visitar y descubrir», los operadores pueden programar visitas de mantenimiento dirigidas, ya con un diagnóstico preciso y las piezas de repuesto adecuadas disponibles. Este cambio de una operación reactiva a una operación gestionada reduce significativamente tanto la frecuencia como el costo de las visitas al sitio, al tiempo que mejora la fiabilidad del equipo.
P4: ¿Cuál es la diferencia entre las reglas de umbral, la comparación de tendencias y las alertas predictivas?
Las reglas de umbral generan una alerta cuando un valor medido supera un límite predefinido; detectan fallos repentinos y evidentes. La comparación de tendencias analiza cómo evoluciona un parámetro a lo largo del tiempo en relación con su propia historia y con unidades similares, identificando una degradación progresiva que nunca supera un umbral. Las alertas predictivas aplican algoritmos a datos históricos y en tiempo real para identificar condiciones que preceden a un fallo, ofreciendo un margen de tiempo útil para planificar el mantenimiento.
P5: ¿Por qué se recomienda la arquitectura «Nube-Borde-Dispositivo» para la supervisión fuera de la red?
Esta arquitectura de tres capas resuelve el desafío fundamental de la comunicación poco fiable en ubicaciones remotas. La capa de dispositivos se encarga de la detección y el control. La capa de edge recopila, almacena y preprocesa los datos localmente, manteniendo el sistema observable incluso cuando se interrumpe la conexión con la nube. La capa de nube ofrece acceso centralizado, análisis entre distintos sitios y seguimiento de tendencias a largo plazo. Cada capa tiene una función clara, y el sistema sigue siendo funcional incluso cuando una capa no está disponible de forma temporal.
123